Nvidia bringt Groq-Inferenzchip in Produktion und meldet Rekordgeschwindigkeit für KI-Agenten

Kurz & Knapp
- Nvidia startet die Vollproduktion seines neuen Inferenz-Beschleunigers Groq 3 LPX, der auf die schnelle Token-Generierung für KI-Agenten spezialisiert ist.
- In einem Benchmark erreichte das System 3.400 Token pro Sekunde und übertraf laut Nvidia den Konkurrenten Cerebras damit um das Vierfache.
- Fachleute kritisieren den Vergleich jedoch als geschönt, da Nvidias Architektur für dieses Ergebnis mindestens 64 Chips benötigt, während Cerebras mit ein bis zwei Beschleunigern auskommt.
Nvidia hat seinen spezialisierten Inferenz-Beschleuniger Groq 3 LPX in die Vollproduktion überführt. Ein unabhängiger Benchmark bescheinigt Spitzenwerte bei der Token-Generierung, doch Fachleute warnen vor einem geschönten Vergleich.
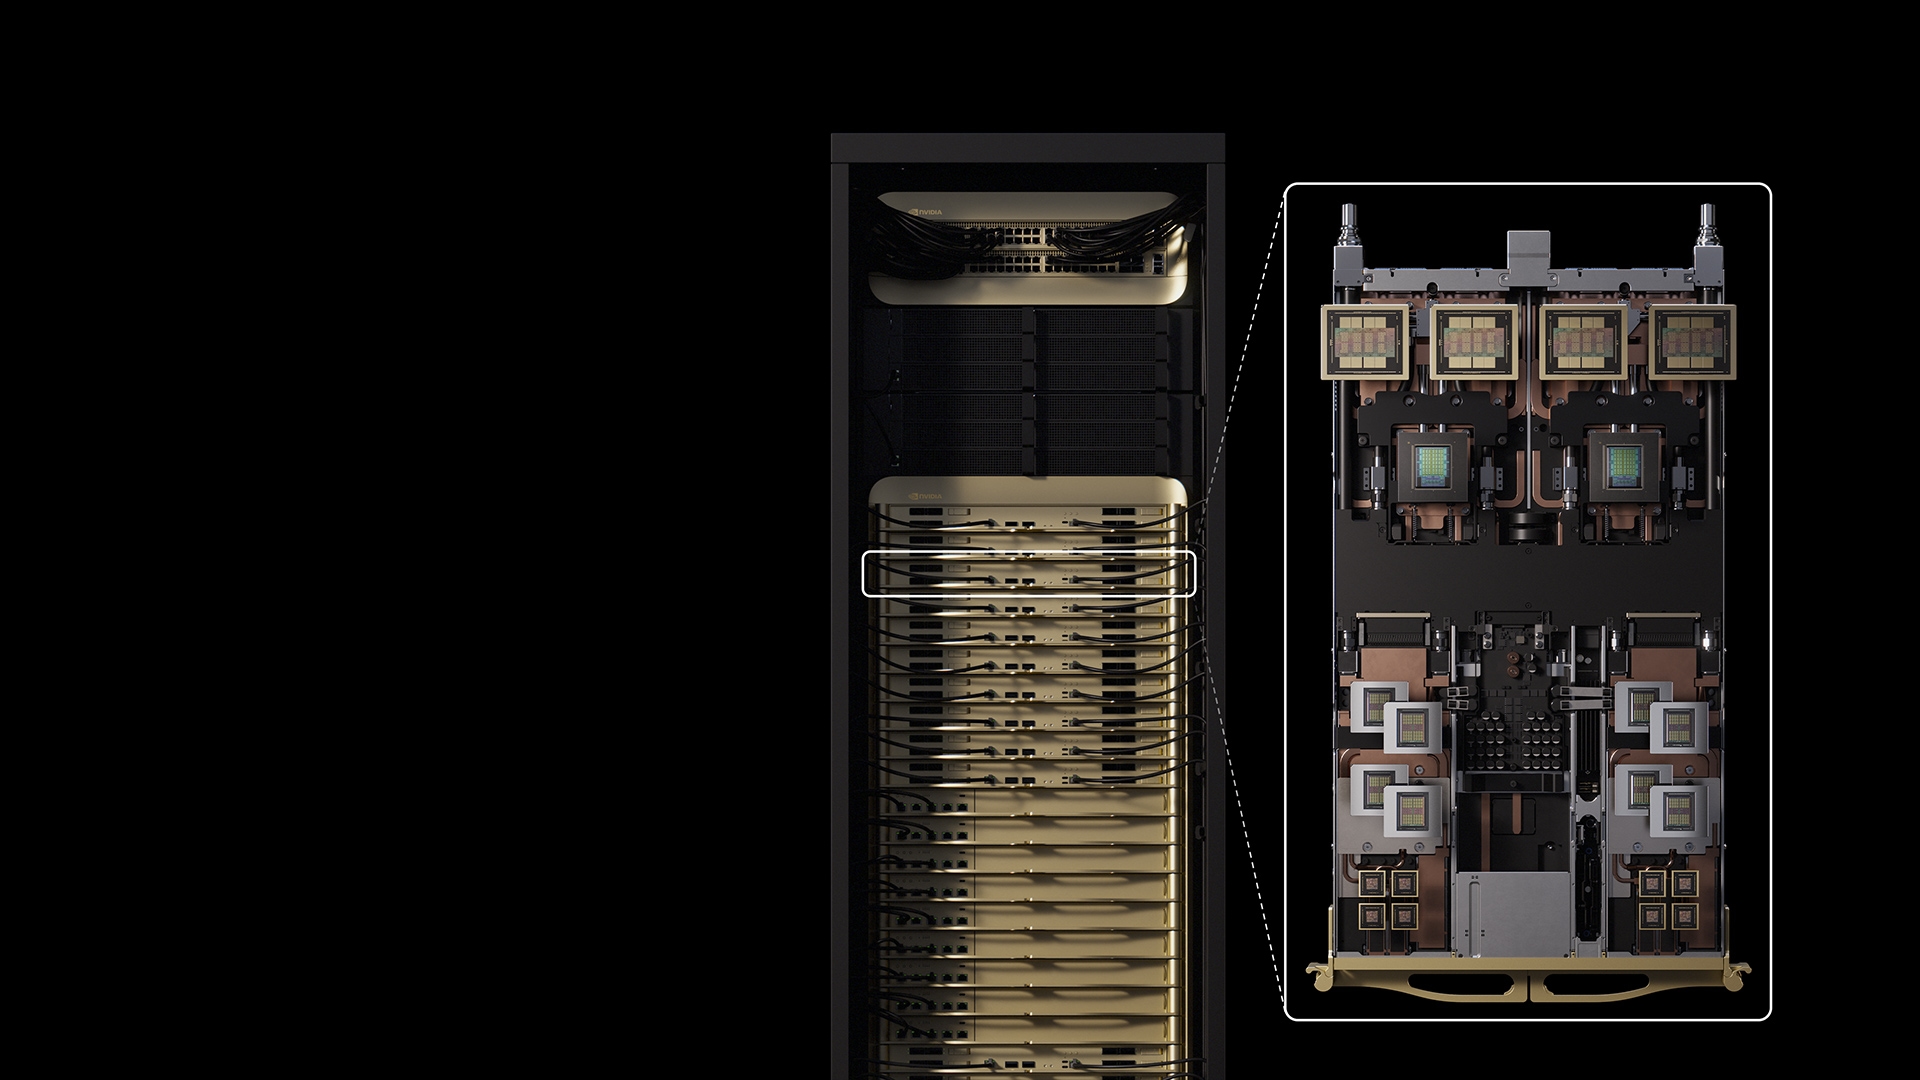
Nvidia hat auf der Konferenz Hot Chips 2026 angekündigt, dass sein Groq 3 LPX in Vollproduktion gegangen ist. Der als "interactive AI inference accelerator" bezeichnete Chip ist eine Erweiterung der Vera-Rubin-Plattform und soll ultraschnelle Token-Generierung für agentische KI-Systeme liefern. Der Betrieb soll laut Nvidia noch in diesem Jahr aufgenommen werden.
Ende Dezember zahlte der Konzern rund 20 Milliarden US-Dollar für die Groq-Lizenz und übernahm Gründer Jonathan Ross sowie Präsident Sunny Madra. Groq entwickelt Prozessoren, die auf Inferenz statt auf KI-Training spezialisiert sind.
Für agentische Anwendungen ist Geschwindigkeit entscheidend: Agenten erzeugen über Hunderte bis Tausende Inferenzschritte enorme Tokenmengen. Je schneller ein System Token generiert, desto mehr Denkschritte und Werkzeugaufrufe passen in dasselbe Zeitfenster. Ein Agent kann also innerhalb einer für Nutzer akzeptablen Wartezeit häufiger iterieren, Dateien prüfen, Code schreiben und testen sowie Ergebnisse verifizieren. Nvidia verspricht dadurch Coding-Aufgaben "in Minuten statt Stunden".
Wie schnell Groq 3 LPX ist, soll ein Benchmark von Artificial Analysis zeigen: Beim offenen Modell Gemma 4 31B mit einem Kontextfenster von 100.000 Token erreichte das LPX-Rack 3.400 Token pro Sekunde, gemessen über 50 aufeinanderfolgende Anfragen. Die Leistung blieb zwischen 10.000 und 100.000 Token Eingabelänge konstant. Es ist der höchste je gemessene Wert für dieses Modell. Nvidia bezeichnet den Beschleuniger damit als viermal schneller als die nächstbeste Alternative, den Cerebras-Chip mit 882 Token pro Sekunde.
Warum der Rekord in der Praxis relativ ist
Groq setzt auf eine SRAM-lastige Dataflow-Architektur. Der Haken laut The Register: Jede LPU verfügt über nur 500 MB Speicher, 576-mal weniger als eine Rubin-GPU mit 288 GB. Modelle werden daher per Ethernet auf mehrere Beschleuniger verteilt, ein Rack fasst bis zu 256 LPUs. In der heterogenen Architektur übernehmen GPUs die rechenintensive Prefill-Phase, die LPUs die bandbreitenintensive Decode-Phase.
The Register ordnet die Zahlen kritisch ein. Gemma 4 31B sei ein Best-Case-Szenario: ein dichtes Modell, das komplett in ein Rack passt. Wie die Architektur bei größeren Mixture-of-Experts-Modellen skaliert, bleibt offen. DeepSeek V3 etwa bräuchte 1.342 Beschleuniger oder gut fünf Racks. Zudem verschweige Nvidia beim Cerebras-Vergleich die Chip-Anzahl: Cerebras benötige für das Modell ein bis zwei Beschleuniger, Nvidia mindestens 64. Cerebras neueste CS-4-Generation ist im Vergleich noch gar nicht berücksichtigt.
Als erster Cloud-Anbieter will Nebius den Chip über seine Token Factory bereitstellen, Groq selbst zählt zu den frühen Nutzern.
KI-News ohne Hype – von Menschen kuratiert
Mit dem THE‑DECODER‑Abo liest du werbefrei und wirst Teil unserer Community: Diskutiere im Kommentarsystem, erhalte unseren wöchentlichen KI‑Newsletter, 6× im Jahr den "KI Radar"‑Frontier‑Newsletter mit den neuesten Entwicklungen aus der Spitze der KI‑Forschung, bis zu 25 % Rabatt auf KI Pro‑Events und Zugriff auf das komplette Archiv der letzten zehn Jahre.
Jetzt abonnieren